写作背景:RTX5080 官方宣传是"第五代 Tensor Core",但我用的指令和 Ampere 时代一模一样。于是开始探究架构与指令集。
1 Tensor Core是什么
在英伟达GPU上通用的处理核心有CUDA Core ,Tensor Core和RT Core。2006年NV提出Tesla架构,CUDA Core出世,当时将这种处理核心称为Stream Processor,在2010年NV发布Fermi架构后将其正式更名为CUDA core。GPU上的核心可以并行的处理任务,所以在Tensor core发布之前,迭代方式以增加更多的核心为主。每一个CUDA core由一个浮点数计算单元FLU和一个逻辑单元ALU组成。
受CUDA core的计算性能和单个GPU上核心数量的限制,在现代大模型训推网络中,CUDA Core难以满足大矩阵的乘法运算。2017年,NV在发布新一代架构Volta时引入了专门用于张量乘法计算的核心:Tensor Core。
Tensor core在硬件层面上支持了混合精度训练,这是加速现代模型训练的核心技术之一,在这里先介绍混合精度训练的概念。
混合精度训练
**训练的不同环节用不同精度——前向/反向的矩阵乘用 FP16/BF16 跑,累加和权重更新用 FP32 。**换来的是显存减半、搬运带宽减半,以及 Tensor Core 的数倍吞吐。
全程 FP16训练会带来以下三个问题:
一:梯度下溢。 FP16 的最小正常数只有 2^-14 ≈ 6.1e-5(再往下的 subnormal 精度极差,更小直接 flush 成 0),而深度网络的梯度分布里经常有一大截落在 6e-5 以下,这部分梯度在 FP16 里静默变零。解法:loss scaling。反向传播前把 loss 乘个系数(如 2^16),梯度整体抬进正常范围,更新前再除回去。
二:权重更新消失。 FP16 尾数只有 10 位,相邻可表示数的相对间隔约 1e-3。而 lr×grad 算出的更新量经常只有权重的 1e-4 量级——w + Δw 四舍五入之后还是 w,神经元权重更新停止。解法:FP32 master weights。参数放在 FP32 里更新,前向/反向只用 cast 出来的 FP16 副本参与计算。
三:长累加误差。 一个 K=4096 的 dot product,如果中间累加值也压成 FP16,舍入误差一路滚雪球。解法:乘法用 FP16,累加器用 FP32
具体而言,混合精度训练每一轮更新的流程如下:
- 将 FP32 的权重转为 FP16,得到一个 FP16 的权重版本用于前向传播过程,同时依然保留 FP32 的权重作为用于后续参数更新的副本。
- Forward 过程使用较低精度进行计算:将 FP16 的激活值(activation)通过 FP16 的各层权重,最终得到 FP16 的 loss。
- Loss Scaling:将 FP16 的 loss 放大若干倍。
- 反向传播:使用放大后的 FP16 loss 进行反向传播,得到 FP16 的梯度(这里的梯度值相比于实际梯度值也是放大后的,其 scale 的倍数等同于上一步 loss scale 的倍数)。由于此时的梯度值是放大后的,因此即便使用 FP16 保存一般也不会出现下溢出问题。
- Gradient Upscaling:将 FP16 的梯度转为 FP32,然后进行反缩放(unscale),得到 FP32 的实际梯度值。这个实际梯度值可能非常小,但此时由于其使用 FP32 进行保存,因此也避免了下溢出问题。
- 最终,使用 FP32 的实际梯度来更新 FP32 的权重副本
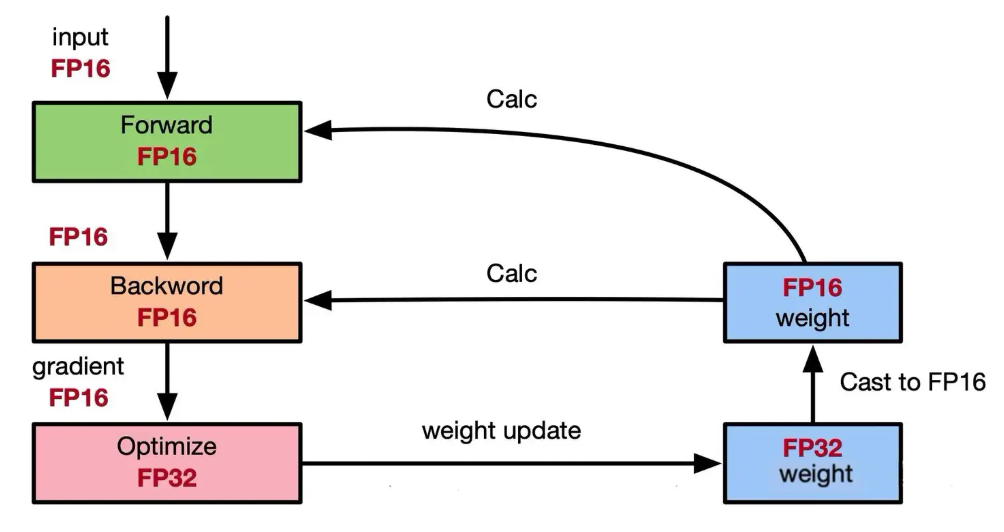
使用混合精度训练能带来的收益很明显:
- 显存:activations 和 gradients 减半(长序列下 activations 是绝对大头;权重反而多一份 FP32 master,但那是小头)
- 带宽:half 化的数据搬运量减半——GEMM 类 kernel 往往就卡在带宽上
- 吞吐:FP16 Tensor Core 是 FP32 CUDA Core 的 8 倍起步
混合精度训练策略需要软件和硬件层面共同支持,NV的Tensor core就是专门设计用于加速FP16计算的,同时保持FP32的精度,一些AI学习框架如Pytorch在软件层面上支持这种策略,于是混合训练策略得以成为现代模型的主流训练策略之一。
Tensor core工作原理
CUDA Core虽然能广泛支持并行的工作模式,但受限于其计算效率,在每个时钟周期内只能执行一次计算操作,并且需要将数据在ALU和寄存器间多次搬运,因而无法完成大规模的矩阵计算任务。
Tensor Core在一个时钟周期内能执行更多的运算,特别是矩阵的乘法和加法操作。
当寄存器仅使用 CUDA Core 时,所有数据都存储在寄存器中,每个寄存器针对一个 CUDA Core 进行数据传输。这样使用 CUDA Core 计算会非常慢。
在 V100 中,每个 Tensor Core 可以处理 8 个线程,每个线程拥有自己的寄存器。因此,在 8 个时钟周期内,可以执行 1024 次 MAC 操作。而在 A100 的 Tensor Core 中,每个 Tensor Core 可以处理 32 条线程,因此在 8 个时钟周期内,可以寄存 2048 次 MAC 操作,每个时钟周期处理其中一块的数据。
在具体计算中,Tensor core在一个时钟周期内能完成一次4x4x4的GEMM操作,共计64次FMA计算,这一操作极大的提升了计算强度。
例如计算D=A*B+C时,ABCD均为4x4的矩阵,矩阵乘法输入的AB为FP16精度,C和D可以设置为FP16或者FP32精度,这也满足了混合精度策略的执行。
Tensor Core与CUDA编程
CUDA编程中一个线程束Warp(32线程)为单位所有线程并行执行。
一个 warp 的 32 个线程集体发射一条 MMA 指令,由 warp scheduler 派发到该 warp 所在 sub-partition 的 Tensor Core 执行;SM 的 4 个 sub-partition 各配独立的 Tensor Core 组,驻留在不同 sub-partition 的 warp 可并行驱动各自的 Tensor Core。
在C++中,NV提供了CUDA C++ wmma的API指令集使开发者可以调用Tensor Core进行计算。
template<typename Use, int m, int n, int k, typename T, typename Layout=void> class fragment;

void load_matrix_sync(fragment<...> &a, const T* mptr, unsigned ldm);
void load_matrix_sync(fragment<...> &a, const T* mptr, unsigned ldm, layout_t layout);
void store_matrix_sync(T* mptr, const fragment<...> &a, unsigned ldm, layout_t layout);
void fill_fragment(fragment<...> &a, const T& v);
void mma_sync(fragment<...> &d, const fragment<...> &a, const fragment<...> &b, const fragment<...> &c, bool satf=false);
load_matrix_sync:Tensor Core 数据加载 API,支持将矩阵数据从 global memory 或 shared memory 加载到 fragment;store_matrix_sync:Tensor Core 结果存储 API,支持将计算结果从 fragment 存储到 global memory 或 shared memory;fill_fragment:fragment 填充 API,支持常数值填充;mma_sync:Tensor Core 矩阵乘计算 API
mma_sync要求操作的矩阵大小为16x16大小,因此在GEMM中常用的Tiling策略也会将矩阵分为16x16的小块以便载入计算。其操作矩阵应提前按load_matrix_sync载入fragment,使Tensor core找到对应元素进行计算。
fragment是Tensor Core进行运算时的寄存器规则,它规定了参与运算的矩阵块中的元素各归属于Warp中哪个线程名下的寄存器,从而使Tensor Core能将这些数据计算组装成完整的结果矩阵,再按此规则写回结果矩阵归属的寄存器。这个规则在不同精度下会有所变化,因为寄存器的容量是有限制的,不同精度元素需要按照不同的规则在寄存器中储存。WMMA API下该规则只能让Tensor core懂得从哪里拿到正确元素,但PTX层上没有公开每个元素的归属,完全由编译器决定,也就是说WMMA API不告诉我们寄存器排布,这也是FA2为什么不能直接调用WMMA API的原因。
fragment实际上是一个C++模版类:
wmma::fragment<wmma::matrix_a, 16, 16, 16, half, row_major> afrag;
通过设置一个 8 槽的寄存器数组 + “ 16×16×16 的 fp16 行主序 A 矩阵”的类型标签
一个 Tensor Core 每个周期可以执行 4x4x4 的 GEMM 运算。然而,在 CUDA 的层面,为什么提供了使用 16x16x16 的 GEMM 运算 API 呢?
事实上,一个 Tensor Core 的最小单元是 4×4 的 MAC 阵列。一个 SM 中有多个(4~8 个)Tensor Core,但硬件并不暴露单 TC 的细粒度控制——粒度太细,指令调度开销会吞掉收益。因此 warp 成了软件到 TC 的握手粒度:一条 MMA 指令由整个 warp(32 线程)集体发射,由 warp scheduler 路由到该 warp 所在 sub-partition 的 Tensor Core 组执行。WMMA API 在这之上提供 16×16×16 的 tile 抽象。
在PTX内联汇编中,我们可以调用mma.sync.aligned.m16n8k16.row.col.f32.f16.f16.f32这样经过一次nvcc编译的ptx指令装载元素,而该指令装载元素的寄存器布局在官方文档里是可以直接查找的,因而我们可以知道每个元素被存在了哪。
以FP16精度下的m16n8k16形状规则为例:
mma.sync.aligned.m16n8k16.row.col.f32.f16.f16.f32
    {d0,d1,d2,d3},    // D:本线程的 4 个 fp32 寄存器
    {a0,a1,a2,a3},    // A:本线程的 4 个 b32 寄存器
    {b0,b1},          // B:本线程的 2 个 b32 寄存器
    {c0,c1,c2,c3};    // C:本线程的 4 个 fp32 寄存器
这样的指令为算子融合等高性能计算优化方式提供了支持。
2 五代架构演进总览
从 Volta 到 Blackwell,Tensor Core 的演进主线可以概括为一句话:逐步将 MMA 的数据通路从寄存器中剥离,同时不断提升指令发射的抽象层级。
- 第一代(Volta / SM70,V100,2017):编程接口为 WMMA API,PTX 层不暴露 MMA 指令(仅存在于 SASS 层的 HMMA);指令粒度为 warp(32 线程);操作数与累加器均位于寄存器;新增精度为 FP16
- 第二代(Turing / SM75,T4 与 RTX 20 系,2018):MMA 指令首次以 PTX 形式开放,核心指令为 mma.m16n8k8;指令粒度仍为 warp;操作数与累加器仍位于寄存器;新增精度为 INT8 / INT4 / INT1
- 第三代(Ampere / SM80,A100,2020):mma.sync 指令集大幅扩充,核心形状为 m16n8k16 等;指令粒度仍为 warp;操作数与累加器仍位于寄存器;新增精度为 BF16 / TF32 / FP64
- 第四代(Hopper / SM90,H100,2022):编程接口为 wgmma + TMA,核心指令为 wgmma.mma_async;指令粒度提升至 warp group(128 线程);B 操作数仅支持从 SMEM 读取,不再经过寄存器,累加器仍位于寄存器;新增精度为 FP8
- 第五代(Blackwell / SM100,B200,2024):编程接口为 tcgen05,核心指令为 tcgen05.mma;单个线程即可发射,CTA 级执行;操作数来自 SMEM / TMEM,累加器直接驻留在 TMEM 中;新增精度为 FP4 / FP6
下面逐代展开,重点分析每一代架构变革的必然性。
3 第一代 Volta(2017):Tensor Core 的起点
V100 之前只有 CUDA Core,FP32 峰值 15.7 TF。V100 的 Tensor Core 将 FP16 提升至 120 TF(dense)——7.6 倍的差距只能依靠专用电路实现:每个 Sub Core 内含 2 个 4×4×4 的 Tensor Core,一个 SM 共 8 个。

上图为V100的单个流处理器微架构,从 SM 微架构看数据流:Register File 将数据传输给 Warp Scheduler,Warp Scheduler 向 Tensor Core 发送 GEMM 运算指令(不经过 Math Dispatch Unit——Tensor Core 拥有专属指令通路);Tensor Core 从寄存器文件接收输入矩阵 A、B、C,执行多次 4×4×4 矩阵乘法,结果写回寄存器文件;寄存器再通过 MIO Data Pipeline 与 Shared Memory 通信。
从一个Sub-Core去看,顶部依然是 L1 Cache,紧随其后的是 L0 Cache,也就是 Register File。Register File 负责将数据传输到 Warp Scheduler,而具体的指令调度则依赖于 Warp Scheduler。针对通用的矩阵计算任务,即 CUDA Core 计算,我们通过 Math Dispatch Unit 将指令分发到具体的 FP64、INT、FP32 和 MUFU 等执行单元进行计算。
这一代的关键设定值得注意:操作数和累加器均位于寄存器中,数据通路为"寄存器 → TC → 寄存器"。该设定延续了三代,直至 Hopper 才被打破。
4 第二代 Turing(2018):整数精度引入,指令集开放
SM75 实现了三项重要改进:
- 整数精度支持:新增 INT8 / INT4 / INT1(面向推理场景),T4 的 INT8 达 130 TOPS。这也是消费级显卡首次配备 Tensor Core(RTX 20 系,DLSS 的起点)
- PTX 指令首次开放:mma.sync 以 m16n8k8 形状进入 PTX ISA,fragment 布局明确写入文档——从这一代起,直接编写 Tensor Core kernel 成为可能。配套的 ldmatrix 指令也同步引入(以 16B 对齐方式从 SMEM 按 fragment 布局直接装载至寄存器)
- FP16 FastPath:每时钟周期可执行高达 32 次计算操作,而 Volta 需要 4~8 个时钟周期才能完成一次多线程 GEMM 计算——吞吐密度大幅提升
此外,Turing 支持线程间共享的 Local Memory:每个线程的私有寄存器被设计为可共享资源,通过透明的共享机制提升矩阵计算的线程协作效率。
5 第三代 Ampere(2020):精度体系完善与搬运解耦
SM80 显著扩充了 mma.sync 支持的形状与精度,同时在两个影响深远的层面进行了改进:
精度侧:FP16 新增 m16n8k16 形状(Turing 仅有 k8)、BF16(指数位与 FP32 同宽,保证训练数值稳定性)、TF32(FP32 矩阵无需手动转换即可使用 Tensor Core)、FP64(A100 独有)、2:4 结构化稀疏(mma.sp,每 4 个权重略去 2 个,性能翻倍)。A100 FP16 dense 达 312 TF,为 V100 的 2.6 倍。
数据搬运侧:引入异步内存拷贝指令 LDGSTS,即 CUDA 层的 cp.async。此前的架构中,GMEM → SMEM 必须经过寄存器中转,既占用寄存器又增加时延;cp.async 实现全局内存到共享内存的直接传输,数据搬运效率提升 3 倍(Movement Efficiency)。
Tensor Core 内部结构同样有改进:A100 每个 Tensor Core 处理 32 条线程(V100 为 8 条),8 个时钟周期可执行 2048 次 MAC(V100 为 1024 次)——线程间数据搬运次数减少,单周期吞吐翻倍。
6 第四代 Hopper(2022):数据搬运与计算解耦
前三代 Tensor Core 均基于 Warp-Level 编程模式:数据从 HBM 加载到寄存器,Warp Scheduler 调用 Tensor Core 完成矩阵运算,结果回传寄存器。这一模式存在两大问题:
- 搬运与计算耦合:warp 内线程分别加载矩阵 Data Tile,每个线程独立获取矩阵块地址;为隐藏加载延迟,需要构建多级软流水(software pipeline),消耗大量寄存器和存储带宽
- 可扩展性受限:寄存器容量限制单个 warp 的矩阵计算规格上限,大模型的矩阵规模增长迅速触及上限
SM90 通过三项关键技术实现解耦:
- TMA(Tensor Memory Accelerator):HBM → SMEM 按 tile 描述符整体异步搬运,单线程发射大块数据搬运指令,硬件自行处理边界、stride、swizzle。数据搬运不再占用 warp 的指令流
- wgmma.mma_async:粒度从 warp(32 线程)提升至 warp group(128 线程),M 固定 64、N 最多 256。关键变化:B 操作数直接从 SMEM 读取(SMEM descriptor 寻址),不再经过寄存器。指令条数大幅减少,发射压力显著下降。指令名中的 async 表示发射后无需阻塞等待,通过 commit_group/wait_group 机制确认完成
- Thread Block Cluster 与分布式共享内存:多个 SM 的 SMEM 可以直接互访,为更大规模 tile 的协作提供支撑
FP8(e4m3/e5m2)和 Transformer Engine 也在这一代引入,H100 SXM FP8 dense 达 1979 TF。TMA + wgmma 的组合正是 FA3 在 H100 上的标准实现方式(producer warp 负责数据搬运,consumer warp group 负责计算,pingpong 交替执行)。
7 第五代 Blackwell(2024):累加器移出寄存器,支持双 SM 协同
SM100(B200 等数据中心卡)的 tcgen05 指令族,是三代以来最大的一次架构改版。
新增 TMEM(Tensor Memory):每个 SM 配备 256KB 专用张量内存(128 lane × 512 列 × 32-bit),不占用 SMEM 也不占用寄存器。MMA 的累加器直接驻留在 TMEM 中。Hopper 已将 B 操作数移出寄存器,但累加器仍在;Blackwell 将最后这一环节也移出寄存器,寄存器彻底退出 MMA 数据通路。
发射模型彻底改变:mma 需要 warp 32 线程集体发射,wgmma 需要 warp group 128 线程,tcgen05.mma 单个线程即可发射(通常由 elected thread 发射)。一整套新指令族围绕 TMEM 展开:alloc/dealloc(分配回收)、ld/st(TMEM 与寄存器间传输)、cp(SMEM → TMEM)、commit/wait/fence/barrier(异步完成确认,与 mbarrier 联动)。
cta_group::2:双 SM 协同:两个配对的 SM(同一 GPC)协作完成一个 M=128 的 MMA,各自负责一半行、各自存储一半累加器。Thread Block Cluster 在此发挥关键作用。
精度下探至 4 bit:FP4 / FP6,配合 MX(microscaling)block scaling 以组内共享指数保障精度。B200 的 FP4 dense 达 9 PF——为 V100 的 75 倍,性能提升路线正是通过逐步降低位宽实现的。
关键分歧:这套指令仅 SM100 及以上架构支持。SM120(RTX 50 消费级)没有 tcgen05、没有 wgmma、也没有 TMA——PTX ISA 将这些指令绑定在 sm_90a / sm_100a 后缀上,消费级显卡无法执行。因此开篇问题的答案是:5080 的"第五代"指的是 Tensor Core 硬件性能;指令集层面,它仍处于 Ampere 的延长线上——在 5080 上编写 kernel,MMA 的上限就是 mma.sync + cp.async。
8 演进规律总结:三条主线
主线一:数据通路,寄存器逐步退出。
Gen1-3:  HBM → SMEM → 寄存器 → TC → 寄存器(累加器)
Gen4:    HBM → SMEM → TC → 寄存器(B 不再经过寄存器)
Gen5:    HBM → SMEM → TC → TMEM →(需要处理时才加载进寄存器)
各代演进的动机一致:寄存器是 SM 中最紧张、最稀缺的资源,过度占用会直接压缩 occupancy。
主线二:指令发射粒度不断提升。 warp(32 线程集体)→ warp group(128 线程集体)→ 单线程发射 + CTA/双 CTA 执行。指令条数减少,发射压力降低,控制权从集体协作集中到单一发射线程。
主线三:从同步转向异步。 前三代的 mma 是同步阻塞指令,warp 发射后必须等待完成;第四、五代的 mma_async / tcgen05 是异步指令,配合 commit/wait/mbarrier 以协处理器方式编排 Tensor Core。FA3 的 warp specialization、producer-consumer 流水线正是构建在这一层之上。
辅助主线:精度位宽从 16 位逐步降至 4 位,依靠 FP32 累加器和 block scaling 保障数值精度。
9 参考资料
- Tensor Core 架构演进(aisystem-docs)
- PTX ISA 文档:
mma.sync、wgmma、tcgen05章节 - NVIDIA Volta / Turing / Ampere / Hopper / Blackwell 架构白皮书
- CUTLASS 源码:
SM80_16x8x16_F32F16F16F32_TN(FA2 路线)、SM90_*(wgmma 路线)、SM100_*(tcgen05 路线) - FA2 / FA3 论文,以及个人 v2.1 的实测数据(5080,105 TF / cuBLAS 112 TF)